
1. Übersicht
In der industriellen Fertigung entscheiden Sekundenbruchteile über Qualität. Ob Schweißprozesse, Sägeschnitte, Lötvorgänge oder Beschichtungen – überall dort, wo dynamische Prozesse per Kamera überwacht werden, stellt sich dieselbe Frage: Kann ein Machine-Learning-Modell die visuelle Qualitätsbewertung automatisieren?
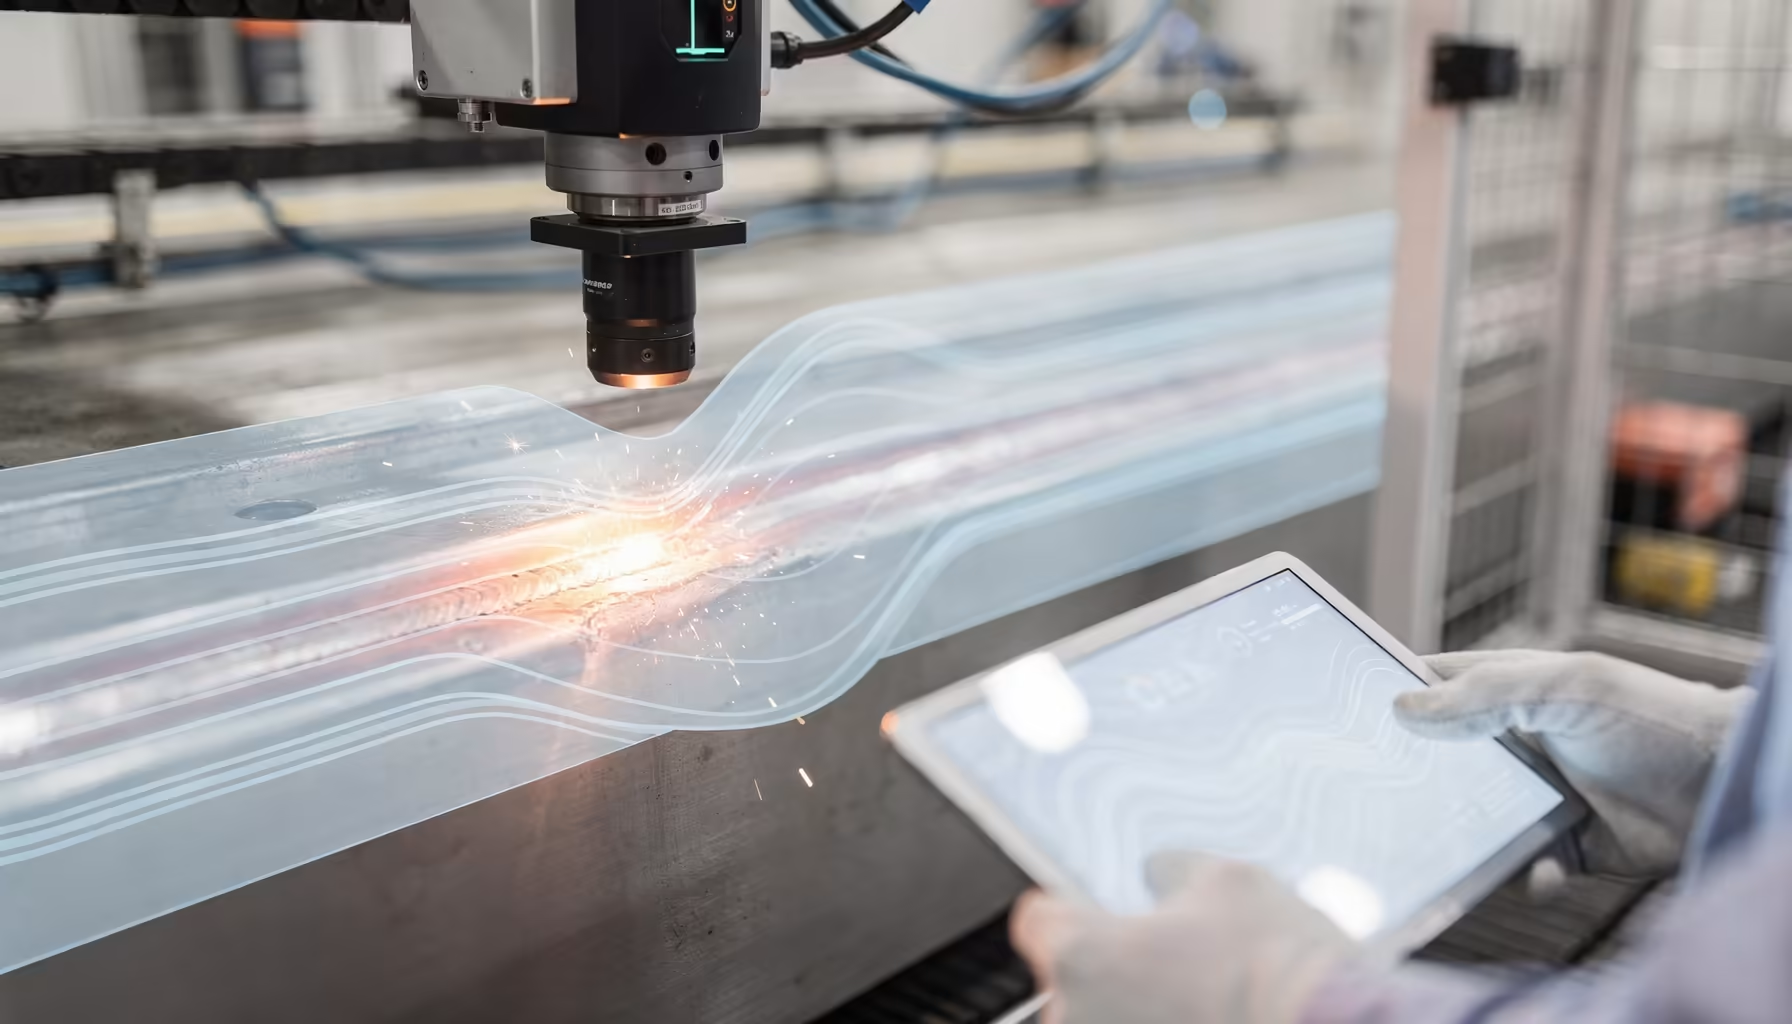
Am Beispiel der Schweißnaht-Inspektion lässt sich exemplarisch durchspielen, welche Methoden heute verfügbar sind, wo sie an ihre Grenzen stoßen und worauf es bei der Umsetzung ankommt. Bei der kameraüberwachten Schweißnahtprüfung werden kurze Videosequenzen des Schweißvorgangs aufgezeichnet. Diese dauern typischerweise wenige Sekunden und zeigen das Verhalten des Schmelzbads, den Nahtverlauf und die Erstarrung. Die Erkenntnisse gelten dabei für eine Vielzahl videobasierter Inspektionsaufgaben in der Fertigung.
Bisher bewertet geschultes Personal solche Aufnahmen manuell: Ist die Naht gleichmäßig? Zeigt das Schmelzbad ein stabiles Fließverhalten? Gibt es Poren, Risse oder Einbrandkerben? Die manuelle Inspektion funktioniert, aber sie skaliert nicht. Sie ist subjektiv, ermüdungsanfällig und vor allem nur punktuell möglich. Kein Experte kann rund um die Uhr vor dem Bildschirm sitzen. Stattdessen werden Anlagen und Prozesse nur zu bestimmten Zeitpunkten stichprobenartig überprüft. Fehler oder Defekte, die zwischen diesen Kontrollzeitpunkten auftreten, bleiben dabei zwangsläufig unentdeckt.
Dieser Beitrag stellt die wichtigsten Methoden für ML-basierte visuelle Qualitätskontrolle vor – von Anomalieerkennung mit Variational Autoencodern über Supervised Classification bis hin zu Explainable AI als Designprinzip. Dabei zeigen wir auch typische Fallstricke, die in der Praxis auftreten, und wie man ihnen begegnet. Zwei Erkenntnisse ziehen sich durch alle Ansätze: Erstens – klassische Bildverarbeitung ist auch im Deep-Learning-Zeitalter unverzichtbar. Zweitens – eine KI-Entscheidung ohne visuelle Begründung ist in der Fertigung wertlos.
2. Die Ausgangslage: Video statt Foto, Prozess statt Momentaufnahme
Anders als bei klassischer visueller Inspektion, wo ein einzelnes Bild ausreicht, liegt dieInformation bei vielen Fertigungsprozessen im zeitlichen Verlauf. Das Schweißen ist eindynamischer Prozess: Die Qualität der Naht hängt davon ab, wie sich das Schmelzbad bewegt,wie gleichmäßig der Lichtbogen brennt und wie die Erstarrung verläuft. Eine Schweißnaht kannim Einzelbild identisch aussehen, aber ob gut oder schlecht entscheidet sich daran, wie sich derProzess entwickelt.[1]
3. Klassische Bildverarbeitung: Das Fundament vor dem neuronalen Netz
Bevor ein einziges Neuron trainiert wird, muss das Bild stimmen. Die klassischeBildverarbeitungs-Pipeline ist bei videobasierter Qualitätskontrolle mindestens so entscheidendwie die Wahl der Modellarchitektur.
Region of Interest: Konturerkennung statt Brute Force
Kamerabilder zeigen weit mehr als die relevante Schweißzone: Spannvorrichtungen,Werkstückränder, Hintergrund. All das ist für die Qualitätsbewertung irrelevant. Schlimmer noch,es liefert dem Modell Signale, die nichts mit der eigentlichen Aufgabe zu tun haben.
Ein automatisierter Cropper erkennt die Position der Schweißnaht im Bild und schneidet denrelevanten Bereich aus. Dahinter steckt keine KI, sondern solides Computer-Vision-Handwerk:Konturerkennung, kameraspezifische Crop-Profile, geometrische Transformation. Für jedesKamera-Setup werden die Crop-Parameter einmalig kalibriert, sodass der Cropper zuverlässigüber verschiedene Produktionslinien hinweg funktioniert.
Das Ergebnis: Ein Großteil des Bildinhalts wird entfernt. Was trivial klingt, erweist sich in derPraxis als einer der wirkungsvollsten Schritte. Weniger irrelevante Pixel bedeuten wenigerMöglichkeiten für das Modell, Shortcut-Features zu lernen – und eine deutlich schnellereKonvergenz beim Training.
Optical Flow: Bewegung als physikalisch interpretierbare Repräsentation
Da die Qualitätsinformation in der Dynamik des Schweißprozesses steckt – in der Bewegungdes Schmelzbads, im Fließverhalten des Materials –, braucht es eine Repräsentation, die genaudiese Dynamik erfasst. Der Farneback-Algorithmus[4] berechnet den optischen Fluss zwischenaufeinanderfolgenden Frames: ein dichtes Vektorfeld, das für jeden Pixel dieBewegungsrichtung und -geschwindigkeit beschreibt.
Der Vorteil gegenüber einem reinen End-to-End-Ansatz: Optical Flow ist physikalischinterpretierbar. Die Flow-Maps lassen sich visuell inspizieren und prüfen, ob sie tatsächlich dieSchmelzbad-Dynamik abbilden – bevor sie einem Modell übergeben werden. Diese Transparenzin der Vorverarbeitung ist ein Qualitätsmerkmal, das in vielen ML-Projekten unterschätzt wird.
4. Methode 1: Anomalieerkennung mit Variational Autoencodern
Ein häufiges Szenario in der Fertigung: Viele Beispiele guter Schweißnähte, abervergleichsweise wenige defekte. Ein mögliches Setting für Anomalieerkennung – das Modelllernt, wie „normal“ aussieht, und alles, was davon abweicht, wird als Anomalie markiert.[2]
Variational Autoencoder (VAE) sind dafür ein etablierter Ansatz. Ein VAE lernt eine komprimierteRepräsentation der Eingabedaten und rekonstruiert sie. Trainiert man ausschließlich auf gutenTeilen, sollte der Rekonstruktionsfehler bei defekten Teilen höher ausfallen.[3]
In der Praxis zeigen sich jedoch deutliche Unterschiede je nach Variante:
Full-Frame VAE mit Optical Flow
Aggregierte Flow-Maps des gesamten Videos als Eingabe. Vorteil: Das gesamte Prozessgeschehen wird in einer einzigen Repräsentation komprimiert – dasModell erhält ein ganzheitliches Bild der Schweißdynamik. Nachteil: Die Aggregation fasst vielInformation zusammen; lokale Defekte – eine einzelne Pore, ein kurzer Riss – können imGesamtbild untergehen. Zudem besteht die Gefahr, dass das Modell kontextuelle Muster lerntstatt tatsächlicher Defektmerkmale (siehe nächster Abschnitt).
Patch VAE
Vorteil: Durch die Zerlegung in kleine 64×64-Pixel-Patches kann das Modell lokaleAnomalien gezielter erfassen – etwa einzelne Poren oder Risse in der Naht. Nachteil: DiePatches verlieren den räumlichen Kontext. Das Modell sieht nur einen kleinen Ausschnitt und
kann nicht beurteilen, ob ein Muster im Gesamtbild relevant ist. In der Praxis generalisiert dieserAnsatz auf neuen Daten häufig schlecht.
Frame VAE mit SSIM-Loss.
Vorteil: Diese Variante arbeitet direkt auf Grayscale-Einzelframesund nutzt den Structural Similarity Index (SSIM) statt des üblichen Mean Squared Error alsVerlustfunktion. SSIM erfasst strukturelle Ähnlichkeit besser als pixelweise Metriken und kanndadurch sensitiver auf Abweichungen reagieren. Nachteil: Die hohe Sensitivität führt in derPraxis häufig zu einer großen Zahl von Fehlalarmen – das Modell meldet auch normaleVariationen als Anomalie. Die Herausforderung liegt darin, den Schwellenwert so zu kalibrieren,dass echte Defekte erkannt werden, ohne den Produktionsfluss durch Falschmeldungen zustören.
5. Fallstrick: Temporale Konfundierung – und wie man sie erkennt
Starke Ergebnisse auf bekannten Daten sehen beeindruckend aus. Doch wenn dasselbe Modellauf Daten eines anderen Produktionstags getestet wird, bricht die Performance eventuelldramatisch ein. Warum?
Die Antwort liegt häufig in der Datenstruktur: Gute Nähte stammen von einemProduktionszeitraum, defekte von einem anderen. Nicht Wochen oder Monate Abstand –manchmal nur wenige Tage. Und trotzdem reicht das: Das Modell lernt nicht, gute vonschlechten Nähten zu unterscheiden, sondern minimale Tagesunterschiede zu erkennen,anhand von Lichtverhältnissen, Kameraposition, Hintergrunddetails oder Materialchargen.
Dieses Phänomen heißt temporale Konfundierung (temporal confounding) und ist in industriellenML-Projekten weit verbreitet, wird aber selten offen diskutiert.[5] Wenn Datenerhebung undLabel systematisch korreliert sind, was in der Fertigung fast unvermeidlich ist, weil Defekte oftchargenweise auftreten, lernt jedes ausreichend mächtige Modell den Shortcut statt daseigentliche Merkmal.
Wie erkennt man temporale Konfundierung?
Explainability-Methoden einsetzen:
Grad-CAM-Heatmaps (siehe unten) zeigen, ob dasModell auf die Schweißnaht schaut oder auf den Hintergrund. Reagiert das Modellausschließlich auf Bereiche außerhalb der Nahtzone, ist das ein klares Warnsignal.
Cross-Domain-Evaluation:
Statt zufällig in Trainings- und Testdaten aufzuteilen, strikt nachProduktionszeiträumen trennen. Kein Frame aus einem Video, das im Training vorkam, darf inden Test gelangen.
Metadaten prüfen:
Korrelieren Labels mit Zeitstempeln, Chargen oder Kamera-IDs? Wenn ja,besteht Konfundierungsgefahr.
Wie begegnet man ihr?
Group-aware Splits und zeitliche Trennung als Standard etablieren
Validierung auf Daten aus einer anderen Produktionscharge als Pflicht definieren
Datenerhebung so planen, dass gute und defekte Teile aus denselben Zeiträumen stammen
6. Methode 2: Supervised Classification mit EfficientNet
Wenn Anomalieerkennung auf Cross-Domain-Daten nicht generalisiert, liegt die Alternative inder überwachten Klassifikation: Statt nur aus guten Beispielen zu lernen, werden beide Klassen– gut und defekt – genutzt.
EfficientNet ist eine bewährte Architektur mit einem guten Verhältnis von Genauigkeit zuModellgröße.[6] Über Transfer Learning von ImageNet-Gewichten und anschließendes Fine-Tuning lassen sich mit vergleichsweise wenigen gelabelten Beispielen robuste Modelletrainieren.[7]
Der entscheidende Unterschied zeigt sich in der Cross-Domain-Evaluation: Währendunbeaufsichtigte Ansätze auf In-Domain-Daten oft vielversprechend wirken, zeigt sich dieStärke der überwachten Klassifikation erst auf Daten aus einem anderen Produktionszeitraum.Hier liefert EfficientNet robustere Ergebnisse, weil das Modell explizit lernt, welche Merkmaleeinen Defekt ausmachen – und nicht nur, was „anders“ aussieht.
Explainable AI: Kein Nice-to-have, sondern Designprinzip
In vielen ML-Projekten wird Erklärbarkeit nachträglich ergänzt, als hübsche Visualisierung fürdie Präsentation. Für industrielle Qualitätskontrolle sollte Erklärbarkeit von Anfang an einbewusstes Designprinzip sein. Jedes Modell muss nicht nur eine Entscheidung liefern, sondernauch die visuelle Begründung dafür.
Der Grund ist pragmatisch: In einer Produktionsumgebung akzeptiert niemand eine Blackbox,die Schweißnähte als „schlecht“ markiert, ohne zu zeigen, warum. Qualitätsverantwortlichemüssen prüfen können, ob das Modell auf das richtige Merkmal reagiert – etwa auf eine Pore inder Naht und nicht auf eine Spannvorrichtung im Hintergrund. Und Prozessingenieure brauchendie visuelle Rückmeldung, um Fehlerursachen einzugrenzen: Liegt das Problem beimDrahtvorschub, bei der Schutzgasabdeckung oder bei den Schweißparametern?
Grad-CAM als integraler Bestandteil der Pipeline
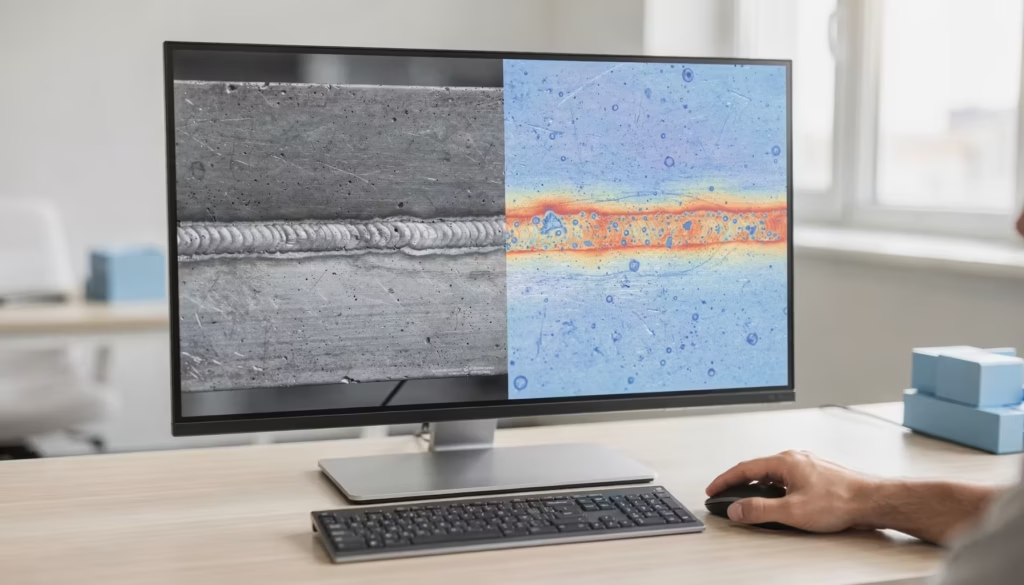
KI-gestützte Schweißnahtprüfung in Aktion: Der Monitor zeigt eine exemplarische Grad-CAM-Heatmap-Analyse, die potenzielle Defektzonen in Korall-Orange hervorhebt und soQualitätsprobleme auf einen Blick sichtbar macht. Ein Techniker wertet die Ergebnisse direkt amArbeitsplatz aus – präzise, effizient und nachvollziehbar.Grad-CAM (Gradient-weighted Class Activation Mapping)[8] sollte nicht als optionales Featureimplementiert werden, sondern als fester Bestandteil der Inference-Pipeline. Bei jederVorhersage erzeugt das System automatisch eine Heatmap, die zeigt, welche Bildbereiche fürdie Entscheidung ausschlaggebend waren.
Die Heatmaps dienen auch als Validierungsinstrument: Reagiert ein Modell aufHintergrundmerkmale statt auf die Nahtzone, ist das ein frühes Warnsignal für temporaleKonfundierung. Ein korrekt arbeitendes Modell fokussiert dagegen auf den Bereich derSchweißnaht – ein entscheidender Unterschied, der sich visuell sofort erkennen lässt.
Erklärbarkeit ist damit nicht nur eine Frage des Vertrauens, sondern ein aktives Debugging-Werkzeug. Wer seine Modelle nicht erklären kann, bemerkt Fehler erst in der Produktion – wosie teuer werden.
7. Methoden im Überblick: Was funktioniert wann?
1. In-Domain-Metriken täuschen
Hohe Metriken auf In-Domain-Daten sind verführerisch. Aber wenn Trainings- und Testdatenaus demselben Kontext stammen, misst man Overfitting, nicht Generalisierung. In der Fertigungist die Versuchung besonders groß, weil Daten oft chronologisch gesammelt werden undnatürliche Cluster bilden.
2. Cross-Domain-Evaluation ist Pflicht
Jedes industrielle ML-Projekt muss von Anfang an klären: Wie stelle ich sicher, dass meinModell auf neuen Daten funktioniert – nicht nur auf Daten, die den Trainingsdaten ähnlichsehen?
3. Klassische Bildverarbeitung ist kein Relikt
Region-of-Interest-Erkennung, Optical-Flow-Berechnung, Kamera-Kalibrierung – all das ist keinÜberbleibsel aus der Vor-Deep-Learning-Ära, sondern Grundvoraussetzung für einfunktionierendes System.
4. Erklärbarkeit gehört in die Architektur
Grad-CAM-Heatmaps sind kein akademisches Extra. Sie sind die Brücke zwischen dem Modellund den Menschen, die damit arbeiten – und gleichzeitig ein Debugging-Werkzeug, das Fehlersichtbar macht, bevor sie in die Produktion gelangen.
8. Fazit und Ausblick
Industrielle ML-basierte Qualitätskontrolle funktioniert anders als Kaggle-Wettbewerbe. Dieeigentliche Herausforderung liegt nicht im Modell, sondern im Zusammenspiel von Kamera-Know-how, klassischer Bildverarbeitung, robuster Evaluation und erklärbarer KI.
Die vorgestellten Methoden – von VAE-basierter Anomalieerkennung über EfficientNet-Klassifikation bis hin zu Grad-CAM-Erklärbarkeit – bilden ein erprobtes Toolkit für videobasierteInspektionsaufgaben. Die nächsten Entwicklungen gehen in Richtung Video-Transformer-Architekturen, die temporale Information explizit modellieren, sowie in die nahtlose Integrationin bestehende Produktionslinien.
Für Unternehmen, die ML-gestützte Qualitätskontrolle einführen wollen, ist die Kernbotschaft:Investiert in die Daten-Pipeline und die Evaluationsstrategie, bevor ihr in Modellarchitektureninvestiert. Die beste Architektur hilft nichts, wenn sie den Wochentag lernt statt den Fehler.
Quellen
[1] Frontiers in Robotics and AI, „A systematic survey: role of deep learning-based imageanomaly detection in industrial inspection contexts“, 2025. (Open Access) https://www.frontiersin.org/journals/robotics-and-ai/articles/10.3389/frobt.2025.1554196/full
[2] Pinon et al., „Autoencoder-Based Visual Anomaly Localization for Manufacturing QualityControl“, Machine Learning and Knowledge Extraction, 2024. https://www.mdpi.com/2504-4990/6/1/1
[3] Kingma, D. P. & Welling, M., „Auto-Encoding Variational Bayes“, arXiv:1312.6114, 2013. https://arxiv.org/abs/1312.6114
[4] Farnebäck, G., „Two-Frame Motion Estimation Based on Polynomial Expansion“, Proceedingsof the 13th Scandinavian Conference on Image Analysis, 2003.
[5] Schölkopf, B. et al., „Toward Causal Representation Learning“, arXiv:2102.11107, 2021. https://arxiv.org/abs/2102.11107
[6] Tan, M. & Le, Q. V., „EfficientNet: Rethinking Model Scaling for Convolutional NeuralNetworks“, ICML, 2019. https://arxiv.org/abs/1905.11946
[7] Weiss, K. et al., „A survey of transfer learning“, Journal of Big Data, 2016. https://journalofbigdata.springeropen.com/articles/10.1186/s40537-016-0043-6
[8] Selvaraju, R. R. et al., „Grad-CAM: Visual Explanations from Deep Networks via Gradient-based Localization“, ICCV, 2017. https://arxiv.org/abs/1610.02391